Что такое SEO?
Search engine optimization — это процесс оптимизации сайта (а в нашем случае веб-приложения) для улучшения его видимости в поисковых системах.
Ведь в сети очень много сайтов, а пользователю нужно очень быстро выдавать релевантную информацию. Именно для этого существуют поисковые роботы, которые индексируют сайты по некоторым специальным метрикам, которые мы рассмотрим ниже.
По сути весь процесс поисковой индексации можно разделить на 3 этапа:
- Краулинг: сбор данных посредством перехода по страницам сайта и их анализа.
- Индексация: данные обрабатываются и добавляются в индекс поисковой системы — не вдаваясь в подробности курса Инны Александровны скажем, что это просто большая оптимизированная для поиска база данных.
- Ранжирование: происходит оценка страницы на основании специальных метрик. Далее, при пользовательском запросе, система выберет наиболее релевантные сайты и выдаст их.
А зачем вообще SEO?
Это необходимо и для бизнеса, чтобы обойти своих конкурентов, и для улучшения пользовательского опыта, чтобы на первой странице оказывались ожидаемые и нужные результаты.
По каким метрикам определяется релевантность ресурса?
Технические метрики
К этому типу относят:
- Скорость загрузки.
- Адаптивность: например, движок Google использует mobile-first подход, то есть мобильная версия приоритетнее.
- Доступность для самой индексации: есть
robots.txt,sitemap.xml, canonical ссылки и т.п. - Структура и читаемость URL.
Контентные метрики
Здесь важно содержимое сайта. К этим метрикам относят:
- Ключевые слова и семантика: например, если пользователь ищет “купить iPhone 15”, роботы проверяют, есть ли эти слова в
<title>,<h1>,<meta name="description">и основном тексте. - Уникальность контента.
- Доступность для пользователей: должны использоваться
altатрибуты для картинок,ariaатрибуты.
Для продвинутых существует микроразметка. Мы не будем её рассматривать, лишь приведём пример для того же запроса с iPhone 15.
<script type="application/ld+json">
{
  "@context": "https://schema.org/",
  "@type": "Product",
  "name": "iPhone 15",
  "description": "Новый iPhone 15 с улучшенной камерой.",
  "brand": {
    "@type": "Brand",
    "name": "Apple"
  }
}
</script>
Поведенческие метрики
Эти метрики связаны с тем, как пользователи взаимодействуют с сайтом.
- Время на сайте: чем дольше пользователи остаются на сайте, тем выше его релевантность.
- Показатель отказов.
- Глубина просмотра: пользователи должны просматривать несколько страниц за один визит.
- CTR (Click-Through Rate): высокий CTR в поисковой выдаче указывает на то, что заголовок и описание страницы релевантны запросу.
Внешние метрики
Эти метрики связаны с авторитетностью сайта и его популярностью в интернете.
- Обратные ссылки: чем больше качественных обратных ссылок (с авторитетных сайтов), тем выше релевантность. Например, если на сайт ссылаются Forbes или Wikipedia, это повышает доверие.
- Доверие домена: чем выше доверие к домену, тем выше релевантность. Например, если вы захостите свой сайт на GitHub Pages, то он будет одним из первых в поисковой выдаче по вашему запросу.
Что такое SPA?
Single page application — это современный подход к написанию веб-приложений. В последнее время он используется всё чаще обычного ввиду относительной простоты и скорости разработки и поддержки.
Он заключается в следующем: приложение загружает одну пустую (без значимого контента) страницу HTML, а далее её содержимое динамически изменяется по мере взаимодействия с пользователем.
Для дальнейшего исследования мы возьмём React и будем размышлять на тему того как поднимать React приложения в поиске.
Готовь сани летом…
Конечно, было бы идеально, если бы ваша архитектура приложения позволяла оптимизации, о которых мы поговорим ниже. В идеале, вы должны продумывать такие вещи перед отплытием — именно такие случаи для простоты мы и будем рассматривать. Однако есть множество более гибких и простых (тем не менее не таких функциональных) решений для быстрой интеграции в уже написанные проекты.
Server-Side Rendering (SSR)
Теория
Итак, наша основная проблема — это то, что контента на старте страницы нет! Многие поисковые роботы до сих пор очень плохо исполняют JS, из-за чего ваша страница будет записана в индекс в том состоянии, в котором вы её «скормили» роботу:
<!DOCTYPE html>
<html>
  <head>
    <!-- Какие-то стили -->
  </head>
  <body>
    <div id="root"></div>
    <script src="index.js"></script>
  </body>
</html>
И непонятно как определять, релевантен ли ваш ресурс пользователю.
| Отступление о мета-тегах. Вы, конечно, можете задаться вопросом: фундаментальная проблема, конечно, неоспорима, но что насчёт того, чтобы хотя бы добавить мета-теги? Ведь <head> у нас есть, давайте просто отредактируем app.html? Это, конечно, имеет смысл. Более того, это сработает, но только в том случае, если у вас действительно ровно 1 страница. Ведь мета-теги должны быть актуальны для каждой веб-страницы. Дальше мы поговорим о технологиях, позволяющих динамически добавлять мета-теги к каждой странице.
Итак, вернёмся к проблеме пустой страницы. Наша схема выглядит на данный момент так:
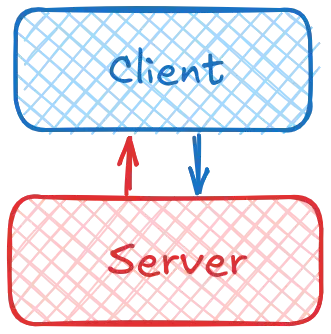
Как нам сделать так, чтобы мы получали контент сразу, не дожидаясь полной загрузки страницы? Отличным решением будет использование шаблонизаторов, но мы работаем с SPA. И именно для них используется SSR.
Давайте мы сделаем сервер-посредник между backend и client. Когда нам нужно что-то получить с сервера, мы обратимся к посреднику в лице метафреймворка, который будет общаться с сервером так как нужно. Схематично, это можно представить так:
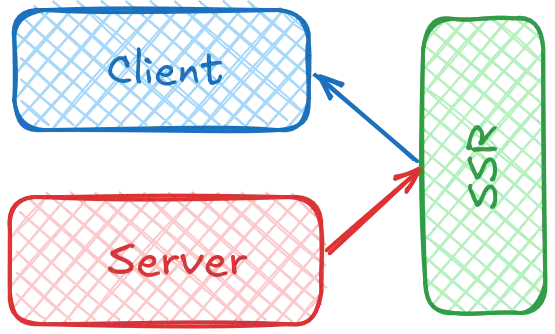
Таким образом, поисковые роботы получат уже пререндеренную страницу и смогут её корректно обработать.
Как имплементировать в React?
Самым популярным и удобным выбором для большинства требований станет Next.js. Это максимально стабильное и резонное решение, которому доверяют многие большие проекты.
Он предоставляет два вида компонентов: 'use server' для серверных и 'use client' для клиентских компонентов. Серверные компоненты имеют доступ к специальной функции getServerSideProps(context), в котором мы можем взаимодействовать с API и возвращать какие-то данные с бекенда.
Такой подход, в частности, позволяет удобно манипулировать cookies или управлять кешированием.
В рамках обзорной лекции мы, конечно, не будем углубляться более подробно в кодовую реализацию (тем более никто не сможет объяснить о том как устроен SSR в Next.js лучше, чем официальная документация), приведём лишь несколько примеров.
Пример 1: простая передача данных через props
export async function getServerSideProps(context) {
  const res = await fetch('https://abaunda.org/post/69');
  const data = await res.json();

  return {
    props: {
      data,
    },
  };
}

export default function Page({ data }) {
  return (
    <div>
      <h1>Данные с сервера:</h1>
      <pre>{JSON.stringify(data, null, 2)}</pre>
    </div>
  );
}
Пример 2: манипуляция заголовками запросов
export async function getServerSideProps(context) {
  const userAgent = context.req.headers['user-agent'];
  return {
    props: {
      userAgent,
    },
  };
}
Пример 3: манипуляция заголовками ответов
export async function getServerSideProps(context) {
  context.res.setHeader('Cache-Control', 'public, s-maxage=10, stale-while-revalidate=59');
  const res = await fetch('https://abaunda.org/post/69');
  const data = await res.json();

  return {
    props: {
      data,
    },
  };
}
Static Site Generation (SSG)
Теория
SSR — очень мощное решение для динамических и часто взаимодействующих с сервером приложений. Однако, если контент на странице меняется не так часто (например, блоги или лендинги), то SSR может стать ненужным оверинжинирингом.
Действительно, зачем нам запрашивать рендер сложного приложения каждый раз, если содержимое будет тем же? Намного разумнее сразу собрать проект в статические HTML-страницы, которые нам будет отправлять сервер.
Такой подход есть и называется Static Site Generation. Главным его преимуществом перед SSR является экстремально быстрая скорость работы.
Однако, если вам нужно разработать что-то более динамическое, то SSG мимо — вам подойдёт SSR.
Как имплементировать в React
Всё тот же Next.js поддерживает SSG. По аналогии с SSR, есть функция для получения статических свойств getStaticProps(). Она выполняется на этапе сборки приложения.
Простой пример использования:
export async function getStaticProps() {
  const res = await fetch('https://abaunda.org/posts');
  const posts = await res.json();

  return {
    props: {
      posts,
    },
  };
}

export default function Blog({ posts }) {
  return (
    <div>
      <h1>Блог</h1>
      <ul>
        {posts.map((post) => (
          <li key={post.id}>{post.title}</li>
        ))}
      </ul>
    </div>
  );
}
SSR + SSG
Да, некоторые фреймворки позволяют комбинировать эти два подхода в рамках одного проекта для более гибкой работы. Как вы могли догадаться, всё зависит от того как вы опишете компонент.
Incremental Static Rendering (ISR)
Иногда бывает необходимо обновлять данные чаще обычного, при этом SSR всё ещё кажется слишком сложным решением. Для таких случаев Next поддерживает ISR для SSG через параметр revalidate:
export async function getStaticProps() {
  const res = await fetch('https://abaunda.org/posts');
  const posts = await res.json();

  return {
    props: {
      posts,
    },
    revalidate: 10, // Regenerate page every 10 seconds
  };
}

export default function Blog({ posts }) {
  return (
    <div>
      <h1>Блог</h1>
      <ul>
        {posts.map((post) => (
          <li key={post.id}>{post.title}</li>
        ))}
      </ul>
    </div>
  );
}
И теперь одна конкретная страница будет пересобираться каждые 10 секунд в фоновом режиме.
Динамические мета-теги
Итак, если с контентом теперь проблем нет, то пришло время разобраться с не менее серьёзной проблемой — мета-теги. Для каждой страницы они должны быть уникальными, поэтому нужно придумать способ как их обновлять.
Так как мы работаем с React, то будем рассматривать решения именно для него. Хотя понятно, что основные принципы будут схожи в большинстве фреймворков.
До React 19
По классике для фронтенд-разработки, если что-то нужно сделать, то для этого есть отдельная библиотека :)
В нашем случае подойдёт React Helmet — он позволяет использовать одноимённый компонент в наших страницах для динамического управления мета-тегами. Пример кода:
import { Helmet } from 'react-helmet';

export default function Post({ post }) {
  return (
    <div>
      <Helmet>
        <title>{post.title}</title>
        <meta name="description" content={post.description} />
        <meta property="og:title" content={post.title} />
        <meta property="og:description" content={post.description} />
        <meta property="og:image" content={post.image} />
      </Helmet>
      <h1>{post.title}</h1>
      <p>{post.content}</p>
    </div>
  );
}
Вот собственно и всё. Это очень простой и проверенный годами способ.
А если вы используете SSR, то рекомендуется использовать обновлённый форк react-helmet-async. Обратите внимание на то, что вам придётся обернуть компонент дополнительно в специальный провайдер.
React 19
В новейшем обновлении React была добавлена встроенная поддержка динамических мета-тегов. Наш код выше можно переписать так:
export default function Post({ post }) {
  return (
    <div>
      <title>{post.title}</title>
      <meta name="description" content={post.description} />
      <meta property="og:title" content={post.title} />
      <meta property="og:description" content={post.description} />
      <meta property="og:image" content={post.image} />
      <h1>{post.title}</h1>
      <p>{post.content}</p>
    </div>
  );
}
Конечно, может сложиться впечатление, что компонент стал «грязнее» — ведь нас учили не мешать мета-теги с обычными. Если вас это напрягает, то можете обернуть их как фрагмент или по-старинке использовать Helmet.
| Важно! Если используете второй способ, то обязательно проверьте, что у вас установлен именно React 19 и выше. В противном случае мета-теги поместятся в ваш корневой компонент, а не всплывут в <head>. Это чревато тем, что роботы просто не прочтут их.
Next.js (предпочтительный способ)
Если вы хотите улучшить SEO, то так или иначе вы используете SSR/SSG, а значит, в большинстве случаев и Next.js.
В него встроен специальный компонент <Head>, который по функциональности такой же, как и <Helmet>, но не требует дополнительной установки и, вообще говоря, является нативным и более уместным решением.
Пример использования:
import Head from 'next/head';

export default function Post({ post }) {
  return (
    <div>
      <Head>
        <title>{post.title}</title>
        <meta name="description" content={post.description} />
        <meta property="og:title" content={post.title} />
        <meta property="og:description" content={post.description} />
        <meta property="og:image" content={post.image} />
      </Head>
      <h1>{post.title}</h1>
      <p>{post.content}</p>
    </div>
  );
}
Что-то ещё?
Мы рассмотрели основные способы SEO-оптимизации SPA, а конкретно особенности SEO для них.
Давайте же имплементируем другие знакомые способы SEO. По ним пробежимся не так подробно, так как различий практически никаких (кроме архитектурных, конечно).
robots.txt
Файл robots.txt указывает поисковым роботам, какие страницы можно сканировать, а какие нет. Бывает удобно таким образом скрыть админ-панель или какие-то страницы, над которыми ещё ведётся разработка.
Обычно его содержимое выглядит так:
User-agent: *
Allow: /
Disallow: /admin
Sitemap: https://abaunda.org/sitemap.xml
В первой строке мы указываем для каких роботов применяем правила (в нашем случае для всех), дальше через Allow и Disallow мы указываем адреса в нашем домене по которым можно и нельзя делать обход соответственно. В последней строке прикрепляем ссылку на карту сайта.
Далее этот файл нужно поместить в public/ или static/ — это нужно для прямого доступа через https://abaunda.org/robots.txt. Готово!
sitemap.xml
Файл sitemap.xml содержит список всех страниц сайта, которые должны быть проиндексированы поисковыми системами.
Конкретно в случае с React (а если точнее, с Next) есть библиотека next-sitemap, которая умеет генерировать sitemap.xml. Вы, конечно, можете написать карту и вручную, но иногда это бывает достаточно утомительным занятием. Проще редактировать готовую карту.
После установки в файле конфигурации next-sitemap.config.js напишем:
module.exports = {
  siteUrl: 'https://abaunda.org',
  // generateRobotsTxt: true,
  // библиотека также умеет генерировать robots.txt
};
Далее, в скрипты в package.json добавим:
"scripts": {
  "postbuild": "next-sitemap"
}
После сборки проекта вы получите sitemap.xml.
Семантическая вёрстка и атрибуты доступности aria
Об этом также никогда не следует забывать!